软件介绍
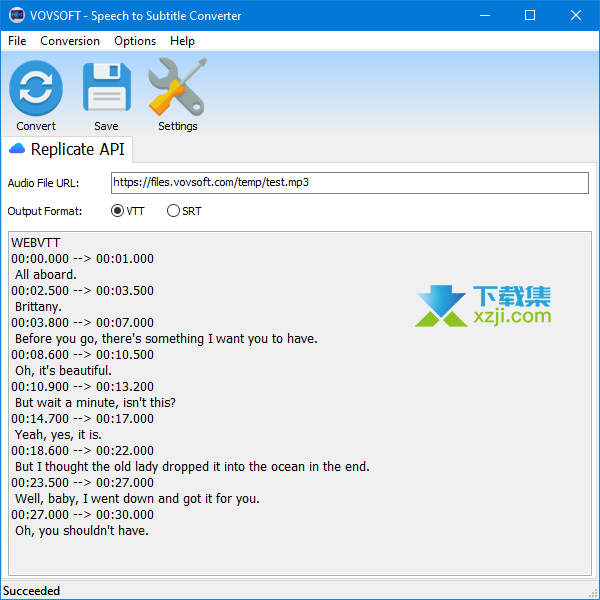
Vovsoft Speech to Subtitle Converter是一款运行在Windows电脑上的AI语音转字幕软件,主要用于从音频或视频中识别人声,并生成带有时间轴的字幕文件。
软件使用本地Whisper AI模型和FFmpeg处理媒体文件,识别过程可以在电脑本地完成,不需要将录音或视频上传到第三方云端。相比依赖在线服务器的字幕生成工具,它更适合处理未公开的视频、采访录音、内部会议和其他对隐私有要求的素材。
除了MP3、FLAC、WAV等音频文件,软件也能从MP4、MKV、AVI、MOV等视频中提取语音。识别结果可以导出为SRT、VTT、JSON或TXT格式,既能用于视频字幕制作,也能整理成会议纪要或文字稿。
小编点评
从实际功能来看,Speech to Subtitle Converter更适合将已有的音频和视频文件转换成字幕。如果你还需要逐句校对、翻译、调整时间轴或制作复杂字幕样式,可以配合Subtitle Edit等字幕编辑软件使用。
主要功能
1. 音视频转字幕
支持导入常见的音频和视频文件,自动识别人声并生成带时间轴的字幕,适合处理课程、采访、会议和短视频素材。
2. 本地离线识别
采用本地Whisper AI进行语音识别,无需上传媒体文件,处理内部会议或未公开视频时更加安心。
3. 支持多种语言
可以识别中文、英语、日语等多种语言,用户可根据音频内容选择对应语言,提高字幕识别效果。
4. 导出常用格式
识别结果可以保存为SRT、VTT、TXT或JSON文件,方便导入剪辑软件、视频平台或继续整理成文字稿。
5. CPU与GPU处理
普通电脑可以使用CPU转换,兼容设备也可开启GPU加速,缩短较长音视频的处理时间。
更新内容
新增Large Turbo语音识别模型支持
改进“显示错误详情”功能
默认启用错误详情显示,方便排查转换问题
近期版本还增加了GPU加速离线Whisper、语言选项和字幕文字编码设置。
下载前请核对软件版本、系统要求及文件大小,安装前建议进行安全扫描。软件授权及使用范围以开发者说明为准。