软件介绍
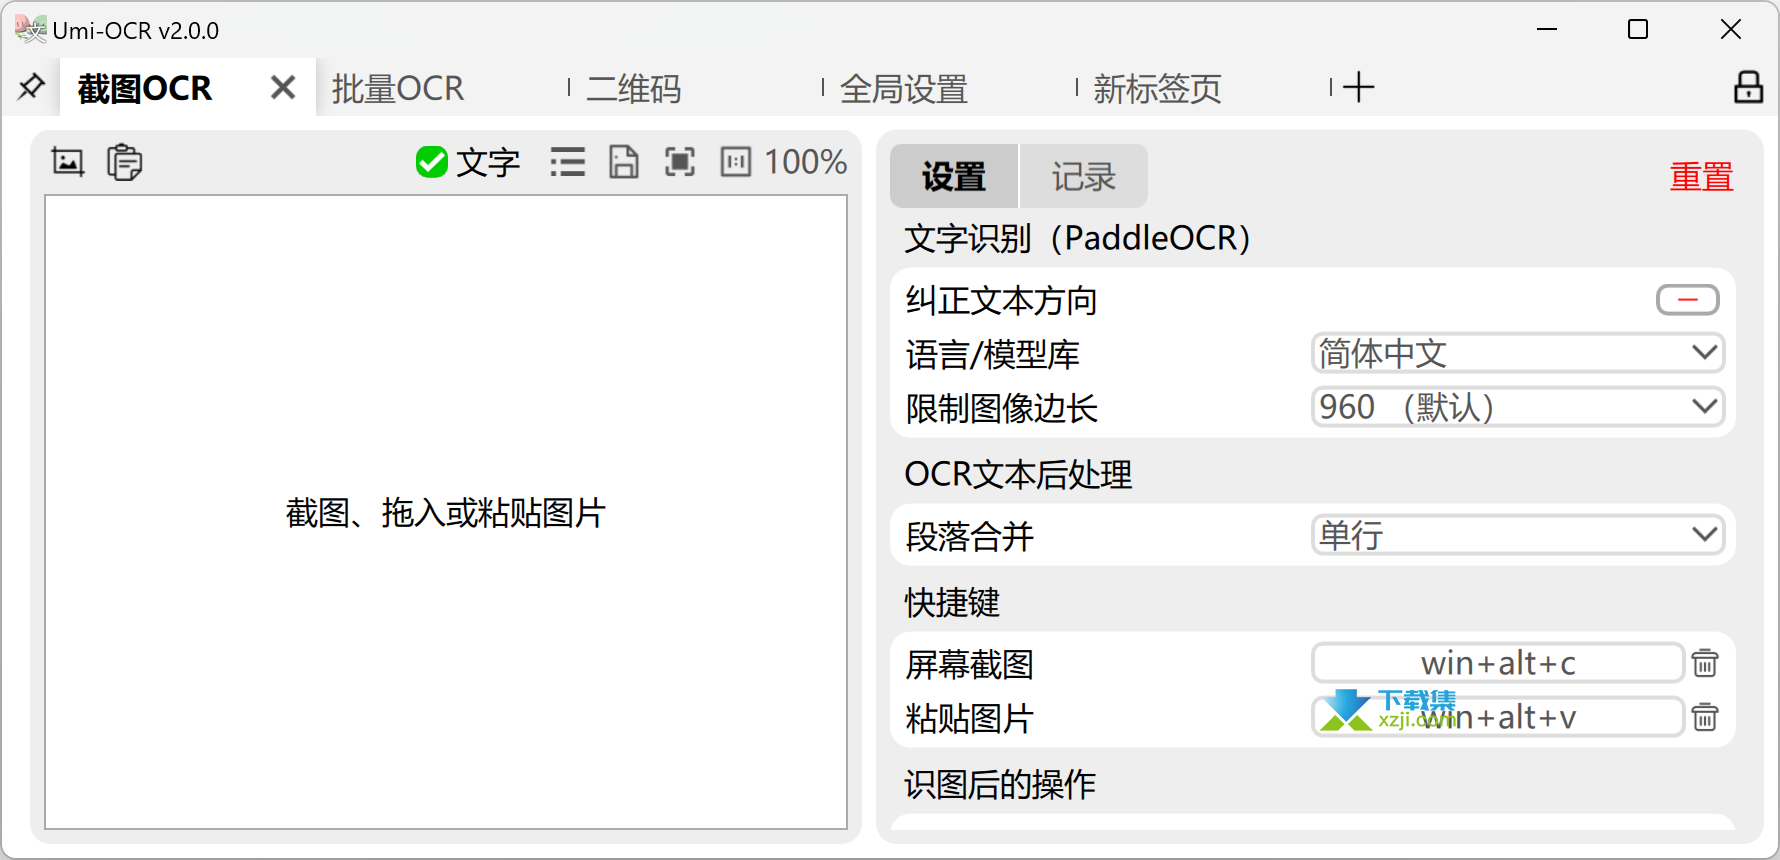
Umi-OCR是一款免费开源的离线OCR文字识别工具,可以把截图、照片、扫描件和PDF中的文字提取出来。整个识别过程都可以在本地电脑完成,不需要上传图片到服务器,比较适合处理工作资料、合同截图以及其他不方便上传到网络的内容。
平时看到网页、聊天记录或者软件界面中的文字无法直接复制时,可以使用截图快捷键进行识别;如果手里有几十张甚至几百张图片,也可以一次批量导入处理。识别结果支持保存为TXT、Markdown、CSV等格式,不需要一张张手动复制。
除了普通图片转文字,Umi-OCR还支持PDF文档识别,可以从扫描版PDF中提取文字,并生成可搜索的双层PDF。同时提供二维码扫描与生成、公式识别、排版整理和忽略区域等功能,例如批量处理带固定水印的图片时,可以排除水印区域,减少无关文字干扰。
软件采用便携式设计,下载解压后即可使用,不需要安装,也没有广告和会员限制。目前提供Paddle和Rapid两种OCR引擎版本:Paddle速度较快,适合性能较好的电脑;Rapid占用更低、兼容性更好,老电脑或者Paddle无法运行时可以优先选择Rapid版。
主要功能
截图OCR
通过快捷键截取屏幕区域后直接识别文字,适合网页、聊天记录、软件界面等无法复制的内容。
批量图片转文字
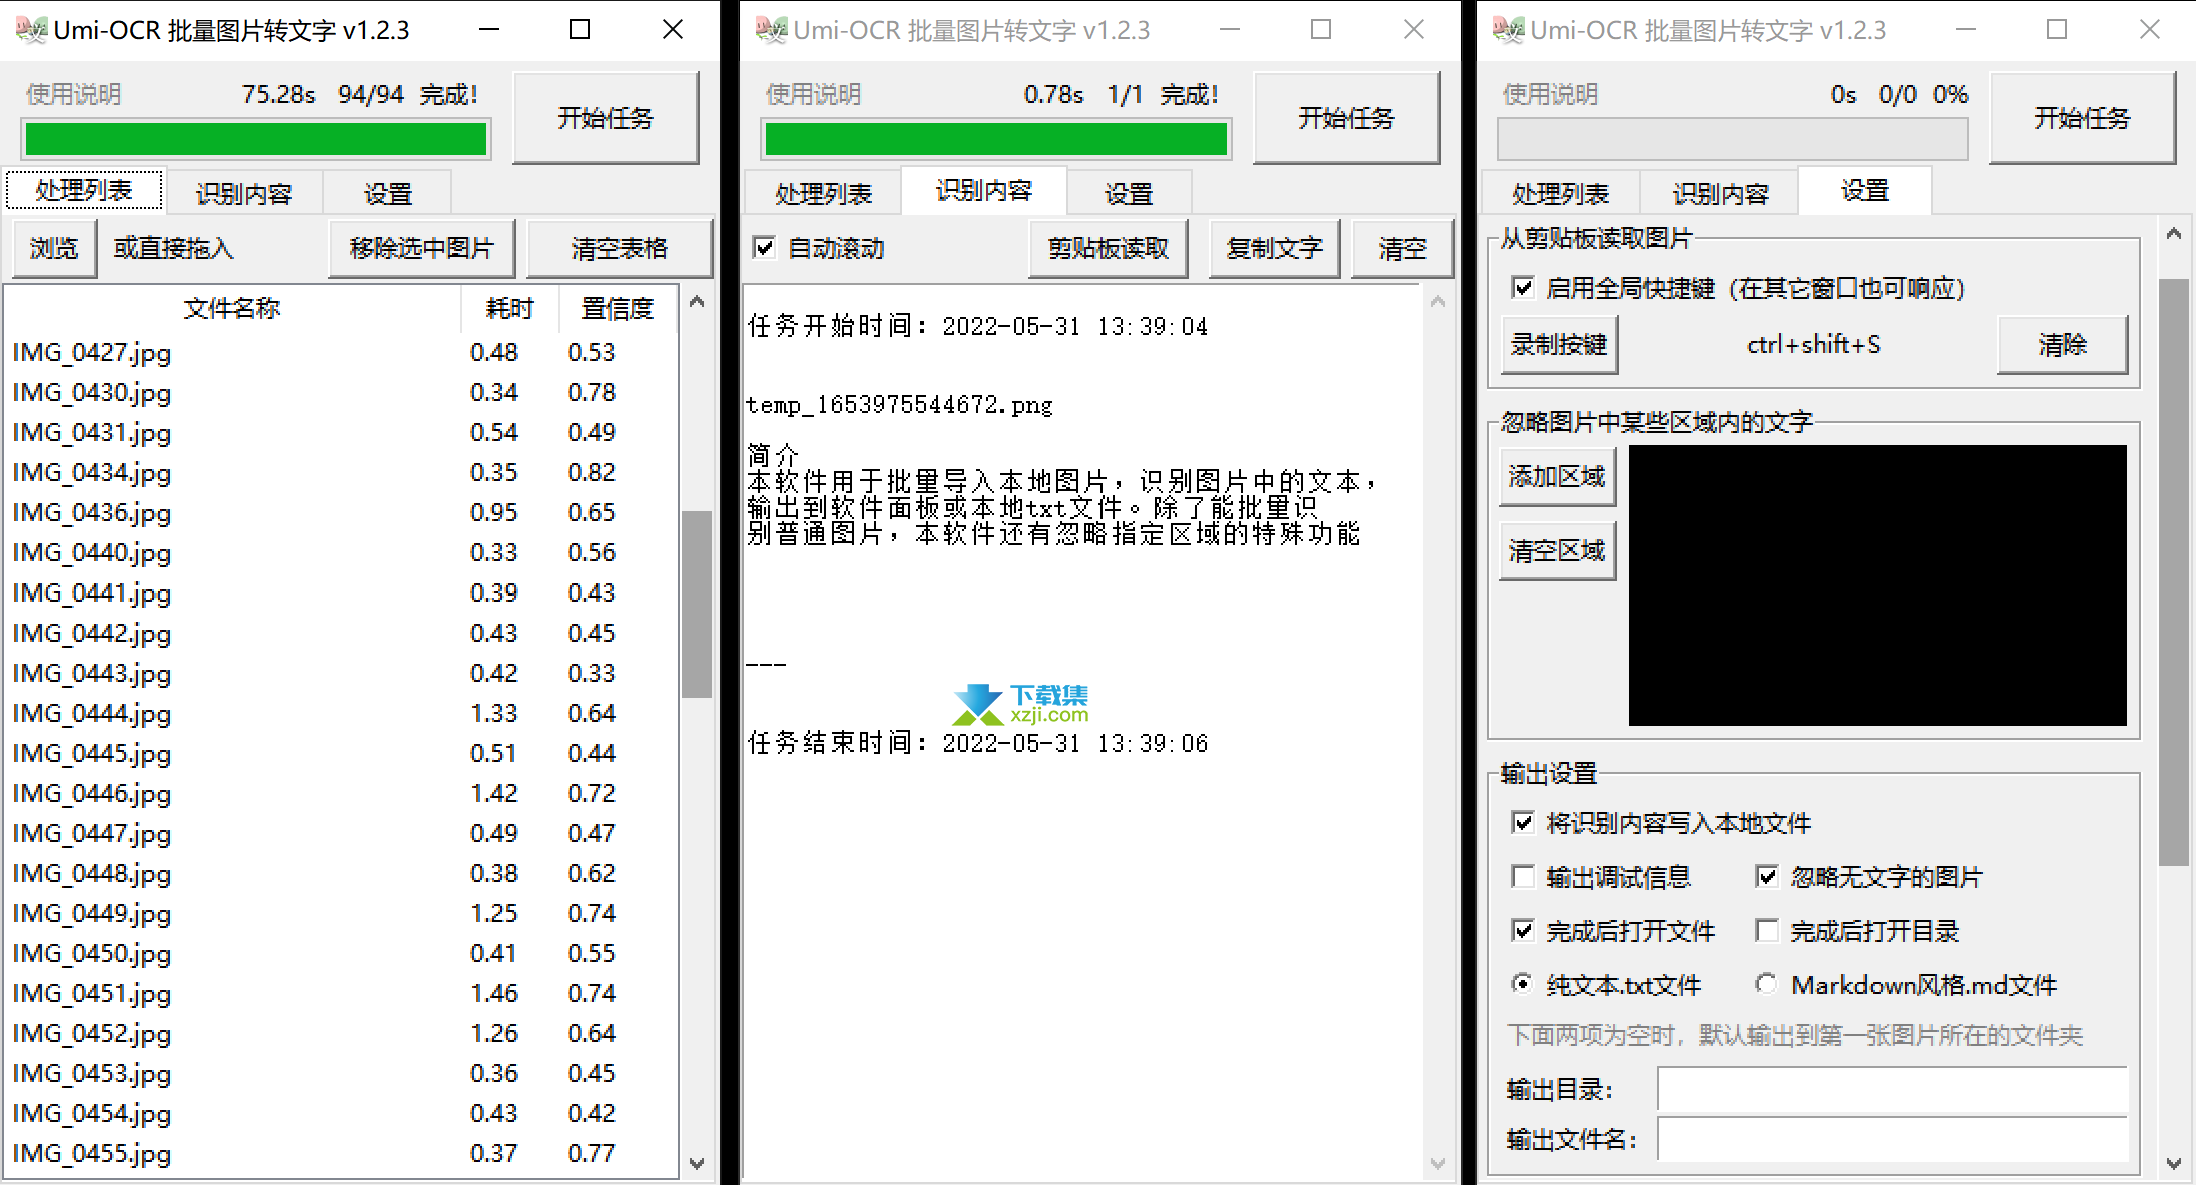
支持一次导入大量JPG、PNG、WebP、BMP、TIFF等图片进行OCR识别,并统一导出结果。
PDF文档识别
可以处理扫描版PDF,从页面中提取文字,也支持生成带文字层的可搜索PDF。
排版自动整理
能够根据原图布局整理文字顺序,支持多栏、单栏、自然段等不同排版方式,识别后的文字更容易直接使用。
忽略水印区域
批量处理图片时可以提前框选不需要识别的区域,例如固定水印、LOGO或页眉页脚,减少无关内容。
二维码与公式识别
除了普通文字,还支持二维码扫描、二维码生成以及公式识别,适合学习资料和技术文档处理。
离线运行
OCR识别在本机完成,不依赖网络,对于涉及个人资料或内部文件的内容更加方便。
使用提示
如果电脑配置较新,可以优先使用Paddle版,识别速度通常更快;如果出现OCR初始化失败、CPU不兼容或者程序无法正常识别,可以换成Rapid版本。
软件无需安装,解压后直接运行Umi-OCR即可。处理重要资料时建议先保留原文件,OCR结果仍可能受到图片清晰度、字体、排版和语言等因素影响。
下载前请核对软件版本、系统要求及文件大小,安装前建议进行安全扫描。软件授权及使用范围以开发者说明为准。